Proyecto en curso · Inteligencia artificial
ExplAIn
Construimos herramientas para entender cómo decide una inteligencia artificial.
- todavía confían en el modelo, después de haber visto la explicación
- 3 de 27
- programas analizados, mitad malware y mitad limpios
- 420
- niveles de riesgo en el AI Act europeo
- 4
- el derecho a una explicación
- Art. 86
Para quien viene de informática, matemáticas, filosofía, derecho
Por qué explicar
Un modelo de inteligencia artificial da una respuesta, pero casi nunca dice por qué. Si la respuesta es correcta por el motivo equivocado, nadie se da cuenta hasta que ese motivo equivocado deja de funcionar.
Los métodos de explicación no cambian el modelo: le ponen al lado una herramienta de diagnóstico, que muestra qué partes de la entrada decidieron la respuesta. Así es como se encuentran los errores que no se ven.
El lobo y la nieve
En 2016, Ribeiro, Singh y Guestrin entrenaron a propósito un modelo equivocado: en todas las fotos de ejemplo los lobos estaban sobre la nieve y los husky no. El modelo aprendió la nieve: dice lobo si hay nieve, husky si no la hay, sea cual sea el animal que aparezca.
Su método, LIME, enciende y apaga grupos de píxeles y observa cómo cambia la respuesta, y después construye un modelo simple que imita al modelo real cerca de esa imagen. La explicación señala la nieve.
Mostraron las respuestas a 27 estudiantes con al menos un curso de machine learning. Antes de la explicación, 10 confiaban en el modelo; después, solo 3.
Los números del gráfico
| Personas | antes de la explicación | después |
|---|---|---|
| Confían en el modelo | 10 | 3 |
| Señalan la nieve como indicio | 12 | 25 |
Integrated Gradients
Otro método parte de una entrada neutra, por ejemplo una imagen negra, y llega a la entrada real en pequeños pasos. En cada paso mide cuánto es sensible la respuesta a cada parte de la entrada, y suma las contribuciones.
IG_i(x) = (x_i − x′_i) · ∫ de 0 a 1  ∂F(x′ + α·(x − x′)) / ∂x_i  dα

x    la entrada real          x′   la entrada neutra
F    el modelo                α    el paso, de 0 a 1

en la práctica: de 20 a 300 pasos, y la suma de las contribuciones debe dar F(x) − F(x′)- 01
Completitud
Las contribuciones sumadas dan exactamente la diferencia entre la respuesta real y la neutra.
- 02
Sensibilidad
Si cambiar una parte cambia la respuesta, esa parte recibe una contribución.
- 03
Independencia del código
Dos redes que calculan la misma función tienen las mismas explicaciones.
- 04
Simetría
Las partes intercambiables e iguales reciben la misma contribución.
El malware y los bytes que no cuentan
Algunos detectores de malware leen directamente los bytes de los programas Windows, y funcionan muy bien. ¿Pero en qué se basan? El estudio de Perasso y colegas, presentado en Ital-IA 2025, lo mide con Integrated Gradients en dos redes, MalConv y BBDNN, con 210 malware de siete familias y 210 programas limpios de Windows 11.
En un programa hay zonas que no deberían contar: la cabecera DOS, que se mantiene solo por compatibilidad; los espacios vacíos entre las secciones; los bytes añadidos al final. Y está el código real, la sección .text. Las dos redes dan la mayor parte de la relevancia al código, pero una parte considerable acaba en las zonas que no cuentan, sobre todo en los espacios vacíos de los programas limpios.
Los números del gráfico
| Red y programas | Relevancia media |
|---|---|
| MalConv (programas limpios) | 0,26 |
| MalConv (malware) | 0,09 |
| BBDNN (programas limpios) | 0,41 |
| BBDNN (malware) | 0,11 |
La traducción del turco
En turco, el pronombre «o» vale tanto para él como para ella. Un estudio publicado en Science en 2017 mostró que, al traducir «O bir doktor. O bir hemşire.», Google Translate escribía «He is a doctor. She is a nurse.»: él médico, ella enfermera. El género no estaba en la frase, lo añadió el modelo, aprendiéndolo de los textos.
Desde diciembre de 2018, para frases breves del turco, Google muestra las dos traducciones. El sesgo estaba en los datos; para verlo hizo falta mirar dentro de las respuestas.
Las normas europeas
El AI Act, el reglamento europeo 2024/1689, está en vigor desde el 1 de agosto de 2024 y divide los sistemas de inteligencia artificial en cuatro niveles de riesgo. Para los de alto riesgo exige transparencia, supervisión humana, exactitud y robustez; y quien sufre una decisión tomada con su ayuda tiene derecho a una explicación, en el artículo 86.
- Riesgo inaceptable prohibido: puntuación social, manipulación, reconocimiento de emociones en la escuela y en el trabajo
- Alto riesgo educación, trabajo, servicios esenciales, infraestructuras críticas, dispositivos médicos
- Riesgo de transparencia los chatbots y los contenidos generados deben declararse
- Riesgo mínimo ninguna obligación: filtros antispam, videojuegos
Los números del gráfico
| Livello | |
|---|---|
| Riesgo inaceptable | prohibido: puntuación social, manipulación, reconocimiento de emociones en la escuela y en el trabajo |
| Alto riesgo | educación, trabajo, servicios esenciales, infraestructuras críticas, dispositivos médicos |
| Riesgo de transparencia | los chatbots y los contenidos generados deben declararse |
| Riesgo mínimo | ninguna obligación: filtros antispam, videojuegos |
- 21 de abril de 2021La Comisión Europea propone el reglamento.
- 1 de agosto de 2024El reglamento 2024/1689 entra en vigor.
- 2 de febrero de 2025Se aplican las prohibiciones.
- 2 de agosto de 2025Se aplican las normas sobre los modelos de IA de uso general.
- 27 de julio de 2026Entra en vigor el reglamento 2026/1744, que traslada los plazos para el alto riesgo.
- 2 de diciembre de 2027Obligaciones para los sistemas de alto riesgo de las áreas del anexo III, como educación y trabajo.
- 2 de agosto de 2028Obligaciones para la inteligencia artificial dentro de productos regulados, como los dispositivos médicos.
En qué punto estamos
- Junio de 2025En Ital-IA 2025, en Trieste, el estudio sobre las correlaciones espurias en la detección de malware: es uno de los tres casos del proyecto.
- Abril de 2026Presentamos el proyecto en Palazzo della Borsa, con tres casos: imágenes, ciberseguridad y traducciones.
- Próximo pasoUna caja de herramientas que cualquiera pueda reutilizar, lista para las normas europeas sobre inteligencia artificial.
Fotos
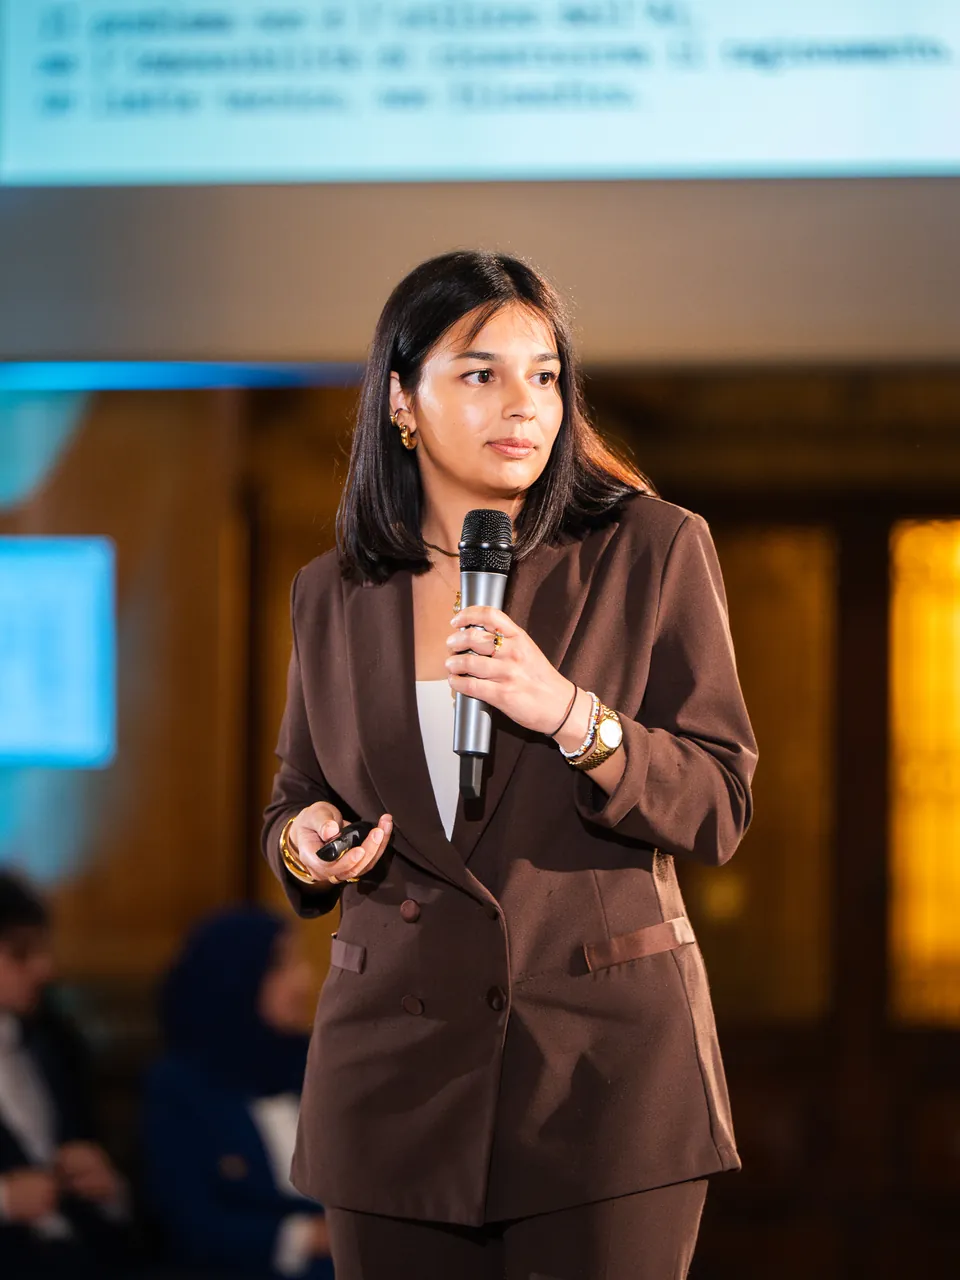
Personas del proyecto
Con quién lo hacemos
Fuentes
- Ribeiro, Singh y Guestrin, «Why Should I Trust You?», KDD 2016.
- Sundararajan, Taly y Yan, Axiomatic Attribution for Deep Networks, ICML 2017.
- Perasso, Lozza, Ponte, Demetrio, Oneto y Roli, Empirical Quantification of Spurious Correlations in Malware Detection, Ital-IA 2025, CEUR Workshop Proceedings 4121.
- Caliskan, Bryson y Narayanan, Science, 2017; Google, Reducing gender bias in Google Translate, 2018.
- Reglamento (UE) 2024/1689 y reglamento (UE) 2026/1744.
- Presentación del Deep-Tech Showcase, Palazzo della Borsa, 21 de abril de 2026.
¿Quieres trabajar en ello?
No hace falta experiencia ni currículum. Escríbenos: te invitamos al próximo encuentro, donde conoces al equipo.