Projet en cours · Intelligence artificielle
ExplAIn
Nous construisons des outils pour comprendre comment décide une intelligence artificielle.
- font encore confiance au modèle, après en avoir vu l’explication
- 3 sur 27
- programmes analysés, moitié malware et moitié sains
- 420
- niveaux de risque dans l’AI Act européen
- 4
- le droit à une explication
- Art. 86
Pour celles et ceux qui viennent de informatique, mathématiques, philosophie, droit
Pourquoi expliquer
Un modèle d’intelligence artificielle donne une réponse mais ne dit presque jamais pourquoi. Si la réponse est juste pour la mauvaise raison, personne ne s’en aperçoit jusqu’à ce que la mauvaise raison cesse de fonctionner.
Les méthodes d’explication ne changent pas le modèle : elles lui ajoutent un outil de diagnostic, qui montre quelles parties de l’entrée ont décidé la réponse. C’est ainsi qu’on trouve les erreurs qu’on ne voit pas.
Le loup et la neige
En 2016, Ribeiro, Singh et Guestrin ont entraîné exprès un modèle erroné : sur toutes les photos d’exemple, les loups étaient sur la neige et les huskies non. Le modèle a appris la neige : il dit loup s’il y a de la neige, husky s’il n’y en a pas, quel que soit l’animal présent.
Leur méthode, LIME, allume et éteint des groupes de pixels et regarde comment change la réponse, puis construit un modèle simple qui imite le modèle réel près de cette image. L’explication met en évidence la neige.
Ils ont montré les réponses à 27 étudiants ayant suivi au moins un cours de machine learning. Avant l’explication, 10 faisaient confiance au modèle ; après, seulement 3.
Les chiffres du graphique
| Personnes | avant l’explication | après |
|---|---|---|
| Font confiance au modèle | 10 | 3 |
| Indiquent la neige comme indice | 12 | 25 |
Integrated Gradients
Une autre méthode part d’une entrée neutre, par exemple une image noire, et arrive à l’entrée réelle par petits pas. À chaque pas, elle mesure à quel point la réponse est sensible à chaque partie de l’entrée, et additionne les contributions.
IG_i(x) = (x_i − x′_i) · ∫ de 0 à 1  ∂F(x′ + α·(x − x′)) / ∂x_i  dα

x    l’entrée réelle          x′   l’entrée neutre
F    le modèle               α    le pas, de 0 à 1

en pratique : de 20 à 300 pas, et la somme des contributions doit donner F(x) − F(x′)- 01
Complétude
Les contributions additionnées donnent exactement la différence entre la réponse réelle et la réponse neutre.
- 02
Sensibilité
Si changer un élément change la réponse, cet élément reçoit une contribution.
- 03
Indépendance vis-à-vis du code
Deux réseaux qui calculent la même fonction ont les mêmes explications.
- 04
Symétrie
Des éléments interchangeables et égaux reçoivent la même contribution.
Le malware et les octets qui ne comptent pas
Certains détecteurs de malware lisent directement les octets des programmes Windows, et fonctionnent très bien. Mais sur quoi se basent-ils ? L’étude de Perasso et ses collègues, présentée à Ital-IA 2025, le mesure avec Integrated Gradients sur deux réseaux, MalConv et BBDNN, avec 210 malware de sept familles et 210 programmes sains de Windows 11.
Dans un programme, il y a des zones qui ne devraient pas compter : l’en-tête DOS, qui ne reste que pour la compatibilité ; les espaces vides entre les sections ; les octets ajoutés à la fin. Et il y a le code réel, la section .text. Les deux réseaux donnent l’essentiel de la pertinence au code, mais une part importante finit dans les zones qui ne comptent pas, surtout dans les espaces vides des programmes sains.
Les chiffres du graphique
| Réseau et programmes | Pertinence moyenne |
|---|---|
| MalConv (programmes sains) | 0,26 |
| MalConv (malware) | 0,09 |
| BBDNN (programmes sains) | 0,41 |
| BBDNN (malware) | 0,11 |
La traduction depuis le turc
En turc, le pronom « o » vaut aussi bien pour lui que pour elle. Une étude publiée dans Science en 2017 a montré qu’en traduisant « O bir doktor. O bir hemşire. » Google Translate écrivait « He is a doctor. She is a nurse. » : lui médecin, elle infirmière. Le genre n’était pas dans la phrase, c’est le modèle qui l’a ajouté, en l’apprenant à partir des textes.
Depuis décembre 2018, pour les phrases courtes depuis le turc, Google affiche les deux traductions. Le biais était dans les données ; pour le voir, il a fallu regarder à l’intérieur des réponses.
Les règles européennes
L’AI Act, le règlement européen 2024/1689, est en vigueur depuis le 1er août 2024 et divise les systèmes d’intelligence artificielle en quatre niveaux de risque. Pour ceux à haut risque, il exige transparence, surveillance humaine, exactitude et robustesse ; et quiconque subit une décision prise avec leur aide a droit à une explication, à l’article 86.
- Risque inacceptable interdit : notation sociale, manipulation, reconnaissance des émotions à l’école et au travail
- Haut risque éducation, travail, services essentiels, infrastructures critiques, dispositifs médicaux
- Risque de transparence chatbots et contenus générés doivent être signalés
- Risque minimal aucune obligation : filtres antispam, jeux vidéo
Les chiffres du graphique
| Livello | |
|---|---|
| Risque inacceptable | interdit : notation sociale, manipulation, reconnaissance des émotions à l’école et au travail |
| Haut risque | éducation, travail, services essentiels, infrastructures critiques, dispositifs médicaux |
| Risque de transparence | chatbots et contenus générés doivent être signalés |
| Risque minimal | aucune obligation : filtres antispam, jeux vidéo |
- 21 avril 2021La Commission européenne propose le règlement.
- 1er août 2024Le règlement 2024/1689 entre en vigueur.
- 2 février 2025Les interdictions s’appliquent.
- 2 août 2025Les règles sur les modèles à usage général s’appliquent.
- 27 juillet 2026Le règlement 2026/1744, qui décale les échéances pour le haut risque, entre en vigueur.
- 2 décembre 2027Obligations pour les systèmes à haut risque des domaines de l’annexe III, comme l’éducation et le travail.
- 2 août 2028Obligations pour l’intelligence artificielle intégrée à des produits réglementés, comme les dispositifs médicaux.
Où nous en sommes
- Juin 2025À Ital-IA 2025, à Trieste, l’étude sur les corrélations fallacieuses dans la détection de malware : c’est l’un des trois cas du projet.
- Avril 2026Nous avons présenté le projet au Palazzo della Borsa, avec trois cas : images, cybersécurité et traductions.
- Prochaine étapeUne boîte à outils que n’importe qui puisse réutiliser, prête pour les règles européennes sur l’intelligence artificielle.
Photos
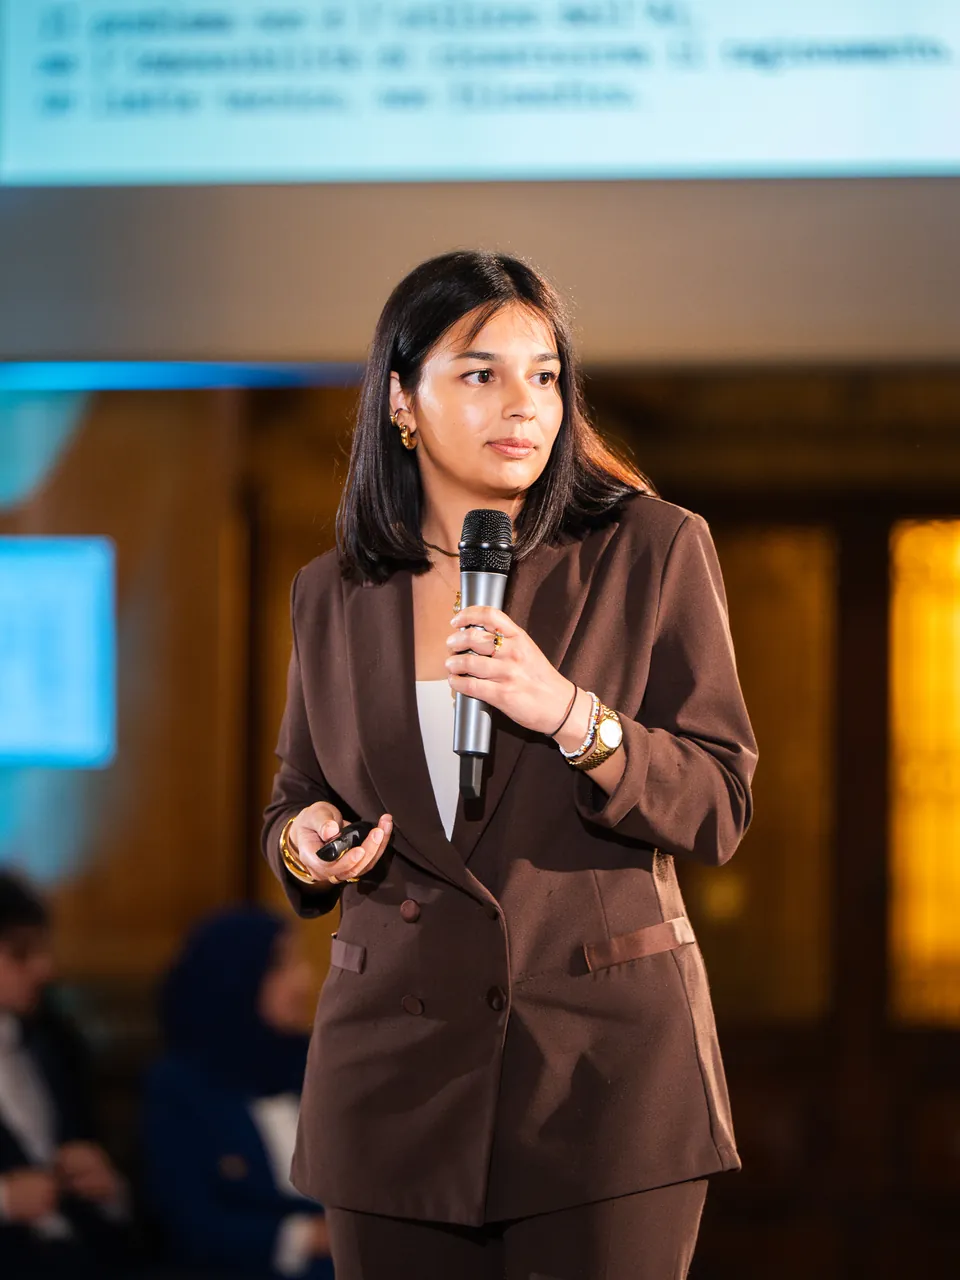
Personnes du projet
Avec qui nous le faisons
Sources
- Ribeiro, Singh et Guestrin, « Why Should I Trust You? », KDD 2016.
- Sundararajan, Taly et Yan, Axiomatic Attribution for Deep Networks, ICML 2017.
- Perasso, Lozza, Ponte, Demetrio, Oneto et Roli, Empirical Quantification of Spurious Correlations in Malware Detection, Ital-IA 2025, CEUR Workshop Proceedings 4121.
- Caliskan, Bryson et Narayanan, Science, 2017 ; Google, Reducing gender bias in Google Translate, 2018.
- Règlement (UE) 2024/1689 et règlement (UE) 2026/1744.
- Présentation du Deep-Tech Showcase, Palazzo della Borsa, 21 avril 2026.
Tu veux y travailler ?
Il ne faut ni expérience ni CV. Écris-nous : nous t’invitons à la prochaine rencontre, où tu fais connaissance avec l’équipe.