Projekt läuft · Künstliche Intelligenz
ExplAIn
Wir bauen Werkzeuge, um zu verstehen, wie eine künstliche Intelligenz entscheidet.
- vertrauen dem Modell noch, nachdem sie die Erklärung gesehen haben
- 3 von 27
- analysierte Programme, zur Hälfte Malware und zur Hälfte sauber
- 420
- Risikostufen im europäischen AI Act
- 4
- das Recht auf eine Erklärung
- Art. 86
Für alle, die kommen aus Informatik, Mathematik, Philosophie, Recht
Warum erklären
Ein Modell der künstlichen Intelligenz gibt eine Antwort, sagt aber fast nie, warum. Wenn die Antwort aus dem falschen Grund richtig ist, merkt es niemand, bis der falsche Grund nicht mehr funktioniert.
Die Erklärungsmethoden ändern das Modell nicht: sie stellen ihm ein Diagnosewerkzeug zur Seite, das zeigt, welche Teile der Eingabe die Antwort bestimmt haben. So findet man die Fehler, die man nicht sieht.
Der Wolf und der Schnee
2016 haben Ribeiro, Singh und Guestrin absichtlich ein falsches Modell trainiert: auf allen Beispielfotos waren die Wölfe im Schnee und die Huskys nicht. Das Modell hat den Schnee gelernt: es sagt Wolf, wenn Schnee da ist, Husky, wenn nicht, egal welches Tier es ist.
Ihre Methode, LIME, schaltet Gruppen von Pixeln ein und aus und beobachtet, wie sich die Antwort ändert, dann baut sie ein einfaches Modell, das das echte in der Nähe dieses Bildes nachahmt. Die Erklärung hebt den Schnee hervor.
Sie haben die Antworten 27 Studierenden mit mindestens einem Kurs in maschinellem Lernen gezeigt. Vor der Erklärung vertrauten 10 dem Modell, danach nur noch 3.
Die Zahlen im Diagramm
| Personen | vor der Erklärung | danach |
|---|---|---|
| Vertrauen dem Modell | 10 | 3 |
| Nennen den Schnee als Hinweis | 12 | 25 |
Integrated Gradients
Eine andere Methode startet bei einer neutralen Eingabe, zum Beispiel einem schwarzen Bild, und nähert sich der echten Eingabe in kleinen Schritten. Bei jedem Schritt misst sie, wie empfindlich die Antwort auf jeden Teil der Eingabe reagiert, und summiert die Beiträge.
IG_i(x) = (x_i − x′_i) · ∫ von 0 bis 1  ∂F(x′ + α·(x − x′)) / ∂x_i  dα

x    die echte Eingabe          x′   die neutrale Eingabe
F    das Modell               α    der Schritt, von 0 bis 1

in der Praxis: 20 bis 300 Schritte, und die Summe der Beiträge muss F(x) − F(x′) ergeben- 01
Vollständigkeit
Die summierten Beiträge ergeben genau den Unterschied zwischen der echten und der neutralen Antwort.
- 02
Empfindlichkeit
Wenn das Ändern eines Teils die Antwort ändert, erhält dieser Teil einen Beitrag.
- 03
Unabhängigkeit vom Code
Zwei Netze, die dieselbe Funktion berechnen, haben dieselben Erklärungen.
- 04
Symmetrie
Austauschbare und gleiche Teile erhalten denselben Beitrag.
Die Malware und die Bytes, die nicht zählen
Manche Malware-Erkenner lesen direkt die Bytes von Windows-Programmen und funktionieren sehr gut. Aber wonach entscheiden sie? Die Studie von Perasso und Kollegen, vorgestellt bei Ital-IA 2025, misst das mit Integrated Gradients an zwei Netzen, MalConv und BBDNN, mit 210 Malware-Beispielen aus sieben Familien und 210 sauberen Windows-11-Programmen.
In einem Programm gibt es Bereiche, die nicht zählen sollten: den DOS-Header, der nur aus Kompatibilitätsgründen bleibt; die leeren Zwischenräume zwischen den Abschnitten; die am Ende angehängten Bytes. Und es gibt den echten Code, den Abschnitt .text. Beide Netze geben den Hauptteil der Relevanz dem Code, aber ein erheblicher Anteil landet in den Bereichen, die nicht zählen, vor allem in den leeren Zwischenräumen der sauberen Programme.
Die Zahlen im Diagramm
| Netz und Programme | Durchschnittliche Relevanz |
|---|---|
| MalConv (saubere Programme) | 0,26 |
| MalConv (Malware) | 0,09 |
| BBDNN (saubere Programme) | 0,41 |
| BBDNN (Malware) | 0,11 |
Die Übersetzung aus dem Türkischen
Im Türkischen gilt das Pronomen „o“ sowohl für ihn als auch für sie. Eine 2017 in Science veröffentlichte Studie hat gezeigt, dass Google Translate beim Übersetzen von „O bir doktor. O bir hemşire.“ schrieb: „He is a doctor. She is a nurse.“: er Arzt, sie Krankenschwester. Das Geschlecht stand nicht im Satz, das Modell hat es hinzugefügt und aus den Texten gelernt.
Seit Dezember 2018 zeigt Google bei kurzen Sätzen aus dem Türkischen beide Übersetzungen. Das Vorurteil steckte in den Daten; um es zu sehen, musste man in die Antworten hineinschauen.
Die europäischen Regeln
Der AI Act, die europäische Verordnung 2024/1689, ist seit dem 1. August 2024 in Kraft und teilt die Systeme der künstlichen Intelligenz in vier Risikostufen ein. Für die mit hohem Risiko verlangt er Transparenz, menschliche Aufsicht, Genauigkeit und Robustheit; und wer von einer mit ihrer Hilfe getroffenen Entscheidung betroffen ist, hat nach Artikel 86 das Recht auf eine Erklärung.
- Inakzeptables Risiko verboten: Social Scoring, Manipulation, Emotionserkennung in Schule und Arbeit
- Hohes Risiko Bildung, Arbeit, wesentliche Dienstleistungen, kritische Infrastrukturen, Medizinprodukte
- Transparenzrisiko Chatbots und generierte Inhalte müssen gekennzeichnet werden
- Minimales Risiko keine Pflicht: Spamfilter, Videospiele
Die Zahlen im Diagramm
| Livello | |
|---|---|
| Inakzeptables Risiko | verboten: Social Scoring, Manipulation, Emotionserkennung in Schule und Arbeit |
| Hohes Risiko | Bildung, Arbeit, wesentliche Dienstleistungen, kritische Infrastrukturen, Medizinprodukte |
| Transparenzrisiko | Chatbots und generierte Inhalte müssen gekennzeichnet werden |
| Minimales Risiko | keine Pflicht: Spamfilter, Videospiele |
- 21. April 2021Die Europäische Kommission schlägt die Verordnung vor.
- 1. August 2024Die Verordnung 2024/1689 tritt in Kraft.
- 2. Februar 2025Die Verbote gelten.
- 2. August 2025Die Regeln für Allzweck-KI-Modelle gelten.
- 27. Juli 2026Die Verordnung 2026/1744 tritt in Kraft, die die Fristen für Hochrisiko-Systeme verschiebt.
- 2. Dezember 2027Pflichten für die Hochrisikosysteme der Bereiche aus Anhang III, wie Bildung und Arbeit.
- 2. August 2028Pflichten für künstliche Intelligenz in regulierten Produkten, wie Medizinprodukten.
Wo wir stehen
- Juni 2025Bei Ital-IA 2025 in Triest die Studie über Scheinkorrelationen bei der Malware-Erkennung: einer der drei Fälle des Projekts.
- April 2026Wir haben das Projekt im Palazzo della Borsa vorgestellt, mit drei Fällen: Bilder, IT-Sicherheit und Übersetzungen.
- Nächster SchrittEin Werkzeugkasten, den jeder wiederverwenden kann, bereit für die europäischen Regeln zur künstlichen Intelligenz.
Fotos
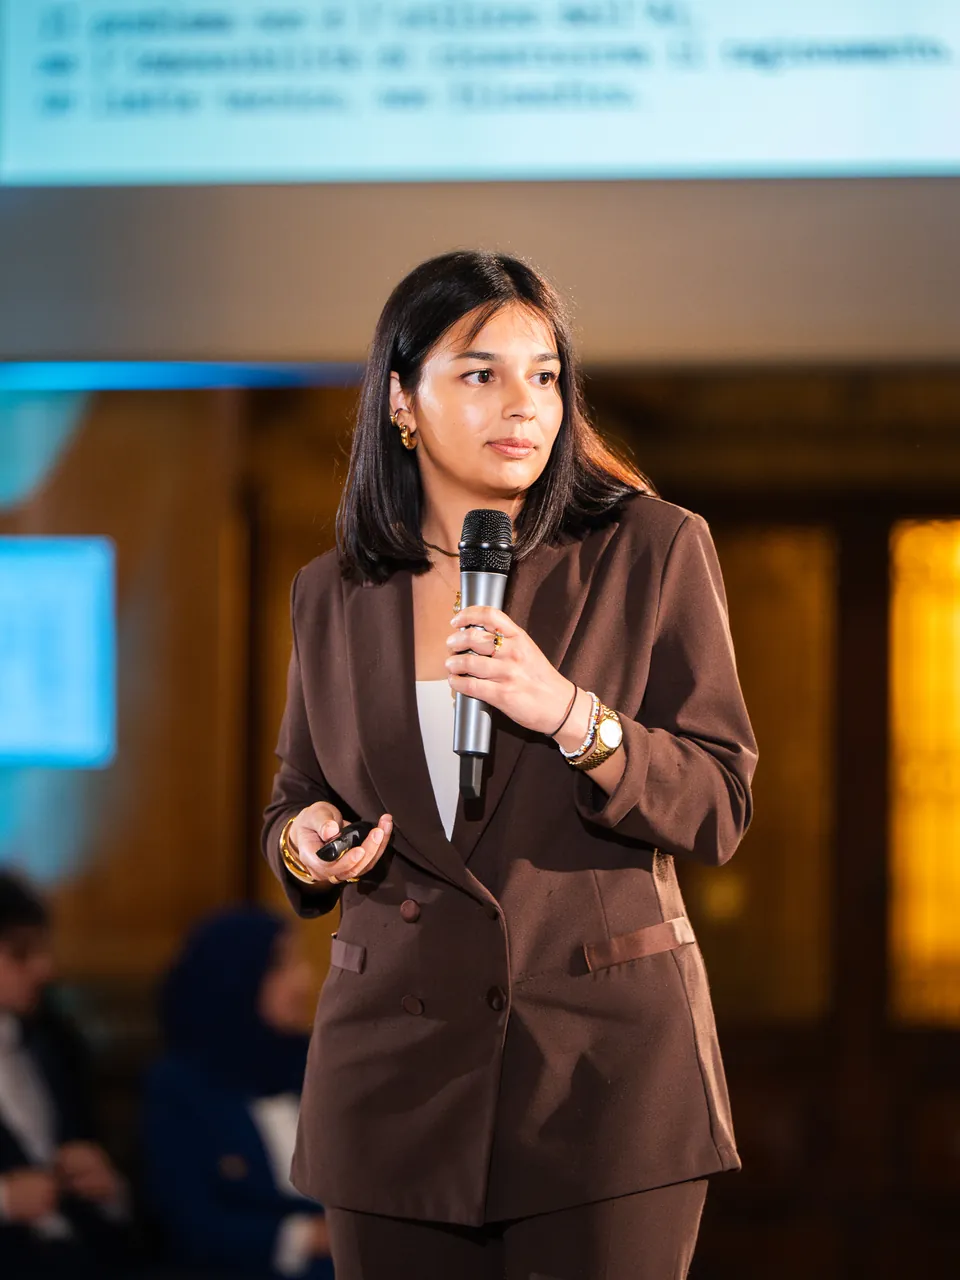
Menschen im Projekt
Mit wem wir es machen
Quellen
- Ribeiro, Singh und Guestrin, „Why Should I Trust You?“, KDD 2016.
- Sundararajan, Taly und Yan, Axiomatic Attribution for Deep Networks, ICML 2017.
- Perasso, Lozza, Ponte, Demetrio, Oneto und Roli, Empirical Quantification of Spurious Correlations in Malware Detection, Ital-IA 2025, CEUR Workshop Proceedings 4121.
- Caliskan, Bryson und Narayanan, Science, 2017; Google, Reducing gender bias in Google Translate, 2018.
- Verordnung (EU) 2024/1689 und Verordnung (EU) 2026/1744.
- Präsentation beim Deep-Tech Showcase, Palazzo della Borsa, 21. April 2026.
Willst du mitarbeiten?
Du brauchst keine Erfahrung und keinen Lebenslauf. Schreib uns: wir laden dich zum nächsten Treffen ein, dort lernst du das Team kennen.